从不完整知识图谱
到鲁棒多跳问答
缺一条边,会怎样?
它把事实存成 (头实体,关系,尾实体) 这样的三元组,也就是图里的一条边。
(巴拉克·奥巴马, 毕业于, 哈佛法学院)
(哈佛法学院, 隶属于, 哈佛大学)
(哈佛大学, 所在地, 剑桥市)
好处是:答案能追溯。系统说「剑桥市」,你能看到它经过了哪两条边。
问题不是直接问一条边,而是要靠串起好几条边才能答。
例:
「奥巴马毕业的那所法学院,在哪个城市?」
必须走完:奥巴马 →毕业于→ 哈佛法学院 →隶属于→ 哈佛大学 →所在地→ 剑桥市
中间任何一步断了,就走不到终点。这就是多跳的代价。
现实里的图谱并不完整。那么——当中间那条边根本不存在的时候,系统该怎么办?
多跳推理是一条串行依赖:第 2 跳的起点是第 1 跳的终点。所以缺一条边的损失不等于「少了一条信息」,而是它后面所有跳全部作废。缺边率每涨一点,性能就会掉得比线性更快。
- 开放世界假设:没写进来 ≠ 不存在
- 知识更新滞后:新事实还没来得及入库
- 抽取误差:长尾实体、稀疏关系最容易漏
2019 年这篇就已经观察到了 GLKMD 今天要讲的那个模式:知识完整时,额外的补充机制不划算、甚至有害;知识缺失时,它才有价值。我在表 1 里报告的「完整图谱上 GLKMD 与 GoG 持平、在 WebQSP 上还低于 ToG」不是失败,而是和这条 2019 年的证据同源的现象。
PullNet 的「迭代拉取」和 GLKMD 的「原子问题串行推进」结构同构:前一步的结果决定下一步查什么。区别在于 PullNet 靠图网络隐式决定方向,不可读;GLKMD 把每一步用自然语言显式写出来,因此每一步都可以被质疑。
AMIE3 从图谱里挖出高置信度的 Horn 逻辑规则(如 hasParent ∧ hasChild ⇒ hasSibling),然后把「能被规则推出来的那条头部三元组」从图里删掉、但保留推理所需的其他三元组——于是答案查不到,只能推出来。再用 GPT-4 依据被删的三元组生成自然语言问题。评测时把所有实体名替换成随机数字 ID,防止模型靠记忆答题;并提出严格的新指标 Hits@Any、Hits@Hard、HHR。① 我用的 Hits@1 区分不了「推理得到 / 直接查到 / 参数里记得」,所以我在论文里只声称「随机缺失压力下的鲁棒性」,绝不外推。② BRINK 说主瓶颈是检索失败(7:3)——这恰好支持 GLKMD 把力气花在原子分解 + LKDL 双向检索上。③ BRINK 的 Hits@Hard / HHR 是我后续应该补上的评测平台,我在局限一节里写明了这一点。
图谱里确实缺了那条边。这是数据问题,任何推理策略都变不出来。
KAR / PullNet 的回答:去找外部文本补(2019 年)。
边在,但搜不到。搜索策略太笨、路径太长、关系方向搞反了,都会让本可走通的路走不通。
这是第二、三、四幕所有方法的主战场。
你以为系统在推理,其实它在背答案。BRINK 证明了这一层不解决,前两层的工作就无法被公正评价。
接下来的四条路线,本质上都是在第二层想办法;
而 GLKMD 想做的是——把第二层和第三层一起处理。
在图上游走
这条路解决了「搜不到」,但解决不了「根本没有」。
ToG 是 GLKMD 原实验的核心基线。看表 1 就知道:完整图谱上 ToG 打 47.2,一旦边被删到 80%,它掉到 31.4——掉了 15.8 个百分点。这个陡坡正是 GLKMD 要削平的对象。
RoG 的「规划」本质上就是一次关系级的问题分解——这是 GLKMD 原子问题分解的直接对标物。GLKMD 的差异在于:分解后要沿依赖链逐步执行并回填上下文,而不是一次性规划完再去检索。
KG-Trie,把问题实体出发 L 跳内的所有合法路径都编码进去。解码时做图约束解码:只要下一个 token 不是合法前缀,就直接屏蔽掉——模型在物理上无法生成图谱之外的路径。再用一个轻量 KG 专用模型(微调后的 Llama-3.1-8B)在约束下束搜索生成 K 条路径和假设答案,交给通用大模型做归纳推理出最终答案。它把「忠实性」这条路做到了极致(100% 路径忠实),GLKMD 在忠实度上几乎不可能超越它。但它把不完整图谱的失败明确留在了门外——这正是 GLKMD 的立足点。也就是说:我不跟它比忠实,我跟它比「缺边时还能不能答」。
- 把「搜索」从一次性查询变成多步探索
- 用图结构约束模型,幻觉从「不可控」压到 33% → 0%
- 推理路径可读、可解释,答案能追溯
- 三篇都假设关键事实能从图里访问到
- 图约束越强,越依赖图完整——约束反而放大了缺失的伤害
- GCR 的失败案例就是「图谱缺信息,无法作答」
一句话:它们优化的是「怎么走」,而缺边问题问的是「路没了怎么办」。
于是有了第三条思路——既然图里没有,那就从别处把知识补进来。
补回来
这条路解决了「根本没有」,但引入了一个更麻烦的问题:你怎么知道它编的是对的?
GoG 的 Thinking-Searching-Generating 和 GLKMD 的 原子分解 + 检索几乎一一对应,也是我表 1 的核心基线。GLKMD 唯一能声称的差异就是:GoG 用一个模型自己审自己,GLKMD 在证据不足时换成几个不同模型互相审。这个差异到底值不值几个点,是我实验必须回答的问题(第 43 页会诚实说明:目前还没有做这个消融)。
KoPL 查询图谱;② 命中就给详细答案,没命中就让模型显式「拆出」缺失的三元组(未知部分写成问号),用参数知识补全;③ 图谱演化:对补全的三元组做 RAG 外部文档验证(Wikipedia + BM25)并修正,再由管理员决定入库。带 human-in-the-loop。is-a Politician)消除歧义。CogMG 认真对待了「生成知识可不可信」,所以它加了 RAG 外部验证 + 人工复核——但人工这一步没法规模化。EoG 走了另一条路:不验证,而是把生成的边界收紧(只做关系化简和本体层级这类结构性生成)。GLKMD 的异构辩论,本质上是想在「不引入人工」的前提下,把 CogMG 那步验证自动化。
- GoG 去掉 Generate 动作就掉点(77.9→74.7)
- CogMG 把补全知识回填图谱后,准确率 44% → 86%
- EoG 用 4 次调用就拿到 CWQ 70.8,性价比极高
- GoG:极度不完整时不如纯 CoT,且只靠模型自己 Verify
- EoG:生成的「新关系」直接当事实用,无核验
- CogMG:靠人工复核兜底,规模上不去
这些方法的共同结构是:先无差别地调用模型能力,再看结果好不好。
GLKMD 想问的是反过来的一件事:能不能只在「证据真的不够」的时候,才调用模型能力?
——这就是我在第 31/34 页要讲的「证据门控」。它既不新(GoG 的 Thinking 就在做类似判断),也不完整(我还没做消融),但它是这套框架的组织原则。
只取要的那块图
这是和我工作重叠最深的一条线——必须讲清楚我到底哪里不一样。
DARA 明确说了「一次只生成一个子任务,根据上一步结果决定是否继续」。这和 GLKMD 第 4.2 节的 qk+1 = Decompose(Q, e | C) 几乎一样。所以我不能在论文里把「迭代分解」当创新点——我的差异只能在后面两步(LKDL 双向检索 + 证据门控后触发异构辩论)。这一点我在相关工作和第 43 页都主动写明了。
[#j] 引用前面子问题的答案),递归求解再整合;叶子节点那种「原子级简单问题」走原子检索——从主题实体出发抽两跳内、经剪枝的候选子图,再「检索 + 重排」取出少量最相关事实喂给模型。全程不训练不微调。KELDaR 的「分解树 → 叶子节点原子问题 → 原子检索相关子图」和 GLKMD 的第一阶段结构上高度同构。所以在论文里:① 我不声称「首次提出原子分解」;② 我的差异必须落在 LKDL 的双向关系(KELDaR 只单向取两跳子图)和 证据不足时的异构模型辩论(KELDaR 只靠单一大模型作答)上;③ KELDaR 面对 Freebase 完整图谱,我做的是不完整图谱——这是任务设定的差别。
SubgraphRAG 用学习到的、双向传播的、可调规模的三元组打分;而 GLKMD 用的是 S = 0.45A + 0.35R + 0.20C 这样一组固定权重 + 硬阈值 θ=0.6的离散规则。这是明显的代差。更要紧的是:这个公式在我自己的稿子里存在数值冲突(见第 34 页,我会当场说明)。
- 分解:从通用任务(DecomP)→ KGQA 迭代分解(DARA)→ 分解树 + 原子检索(KELDaR),已经做透了
- 检索:SubgraphRAG 把三元组打分做成了可学习、可调规模、快两个数量级
- 两者结合的效果非常好(KELDaR 在 CWQ 上 +19.2%)
- 全部在 Freebase 完整图谱上评测
- 检索只解决「找得到」,不解决「压根没有」
- KELDaR 的误判问题说明:分解本身也需要被验证,而它没有验证机制
① 任务换掉——从「完整图谱上答得更准」换成「图谱缺 20%–80% 时退化更慢」;② 补上验证环——分解、检索拿到证据之后,如果证据不够,系统要能察觉并触发别的机制,而不是硬着头皮让同一个模型生成。
第二点,就接到了下一条路线:让多个模型互相质疑。
互相质疑
这条路是 GLKMD 顶层结构的直接来源,也是最危险的地方。
DoG 在 WebQSP 完整图谱上打 88.6,而我的 GLKMD 在 WebQSP 完整图谱上是 73.5;DoG 在 CWQ 上是 58.2,我是 55.7。也就是说:在完整图谱上,DoG 明显强于我。我的表 1 只对比了 ToG 和 GoG,没有对比 DoG——这是组会上很可能被问到的地方,我会在第 44 页主动交代。
M 保存中间结果。② 子问题推理:两个独立检索代理——KG Agent 做实体链接、用 SPARQL 迭代取当前实体的正向与逆向关系、选 top-k 逐步扩证据(链接失败就退回 CoT 兜底);RAG Agent 面向 Wikipedia 文本取 top-k 段落作答。两者各自给出候选答案与推理链,再由 Judge Agent(裁判)评估比较、整合出该子问题的中间答案。③ 最终答案生成:汇总记忆 M 输出全局答案。此外作者用「真实知识更新」重造了新数据集 IKGWQ。它同时覆盖了 GLKMD 的几乎全部要素:面向 IKGQA ✓ · 问题分解成子问题 ✓ · 结构化 KG 检索 ✓ · 连"正向 + 逆向关系"都有了 ✓ · 多代理 + 裁判辩论 ✓ · 甚至还有证据不足退回 CoT 的兜底 ✓。我原稿里"首次引入辩论/首次做双向关系检索"这类表述,在这一篇面前全部不成立。
| 对比项 | DoM (AAAI 2026) | GLKMD(我的) |
|---|---|---|
| 任务设定 | IKGQA ✓ | IKGQA ✓ (同) |
| 问题分解 | 分解成子问题串 ✓ | 原子子问题 + 依赖关系 ✓ (同) |
| 关系方向 | SPARQL 取正向 + 逆向 | LKDL 显式双向标记 # / * |
| 辩论触发 | 每个子问题都跑双代理 + 裁判 | 只在证据不足时触发 |
| 模型同构性 | 所有角色同一个基座 | 异构模型 MA/MB/MC |
| 外部知识源 | 依赖 Wikipedia 文本 RAG | 以图谱为主,模型知识按需补充 |
- 触发时机(证据门控)——最像「机制」,但还没做消融,只能说「更省」,不能说「更准」
- 模型异构——有 Demystifying MAD 的理论支撑,但也没有同预算对照
- LKDL 双向表示——DoM 只是顺带取逆向边,这属于表示层差异,较弱
- 以图谱为主、更节制——是设计取向,不是可测的性能主张
| CWQ | IKG-40% |
|---|---|
| DoM | 62.0 |
| GoG | 60.4 |
| ToG | 52.0 |
| GLKMD | 53.1 |
在 CWQ IKG-40% 这一格,DoM 比我高 8.9 个点。
① 基座不同:DoM 用 DeepSeek-v3,我的表 1 用 GPT-3.5。
② 缺失定义不同:DoM 删的是金标路径上的关键三元组(精准打击,更难);我删的是问题相关图谱里的三元组(更宽松)。
这两个差异是「解释」,不是「借口」。要真正回应,唯一办法是同基座、同缺失构造重跑 DoM 和 GLKMD——已写进投稿前必做清单。
我现在的贡献边界是:不是「首次提出」,而是「在随机缺失压力下,用一套带门控的双向检索 + 异构辩论管线,获得了更平缓的退化曲线」——并且我把这个限定条件明明白白写在摘要里。
支持:它证明了辩论要有效,初始观点必须足够多样,否则会坍缩到初始多数、退化成多数投票。这正好是 GLKMD 用异构模型(而不是同一个模型换角色)的理论依据。警告:① 光有异构还不够,还要加置信度通信与校准,否则轮数再多也不提升;② 辩论不是免费的,DoG 也发现「一轮最好、轮数多了反而变差」——所以 GLKMD 里那套 Ak+1/Bk+1 的多轮公式,实际实现必须控制轮数。
「分解成子问题 → 检索 KG → 不够就用多代理辩论」
这个组合,已经有人做过了——而且是 2026 年 AAAI 的 DoM。
原稿里「首次」「独立提出」这类词,在 DoG、DoM、KELDaR 面前都站不住。我在论文里已经全部删掉,改成限定性表述。
不声称发明了组件,而是声称:在随机删边压力测试下,这套管线呈现出比基线更平缓的退化曲线,并同时报告完整图谱上的持平与负结果。
留下的缺口
这一节我把框架讲清楚,同时把每一处「站不住」的地方标出来。
- 「首次把问题分解成原子子问题」 → KELDaR(EMNLP 2024)、DARA(ACL 2024)已有
- 「首次在 KGQA 中引入辩论」 → DoG(AAAI 2025)已有
- 「首次面向 IKGQA 做分解 + 混合知识辩论」 → DoM(AAAI 2026)已有
- 「首次做双向关系检索」 → DoM 的 KG Agent 已取正向 + 逆向关系
- 「辩论天然优于单模型」 → Demystifying MAD 证明这是错的
- 在 CWQ / WebQSP 的 20%–80% 随机三元组删除设置下,GLKMD 的 Hits@1 退化幅度小于 ToG 和 GoG
- CWQ 下降 7.4 个点(ToG 15.8 / GoG 21.3);WebQSP 下降 8.3 个点(ToG 21.0 / GoG 22.2)
- 相对同设置最强基线的增益:CWQ +8.8 ~ +14.7,WebQSP +1.4 ~ +8.7
- 同时报告完整图谱上的持平与负结果——这是这个主张可信度的一部分
Knowledge-Aware Reader(第 06 页)在 2019 年就发现:KB 完整时,外加的文本证据不划算甚至有害(16.8% 的样本更差);KB 一旦缺失,它才开始有价值。GLKMD 在表 1 里呈现的「完整图谱不占优、缺边时领先」,是同一个模式在 2026 年的复现——这不是实验失败,这是方法的适用范围。
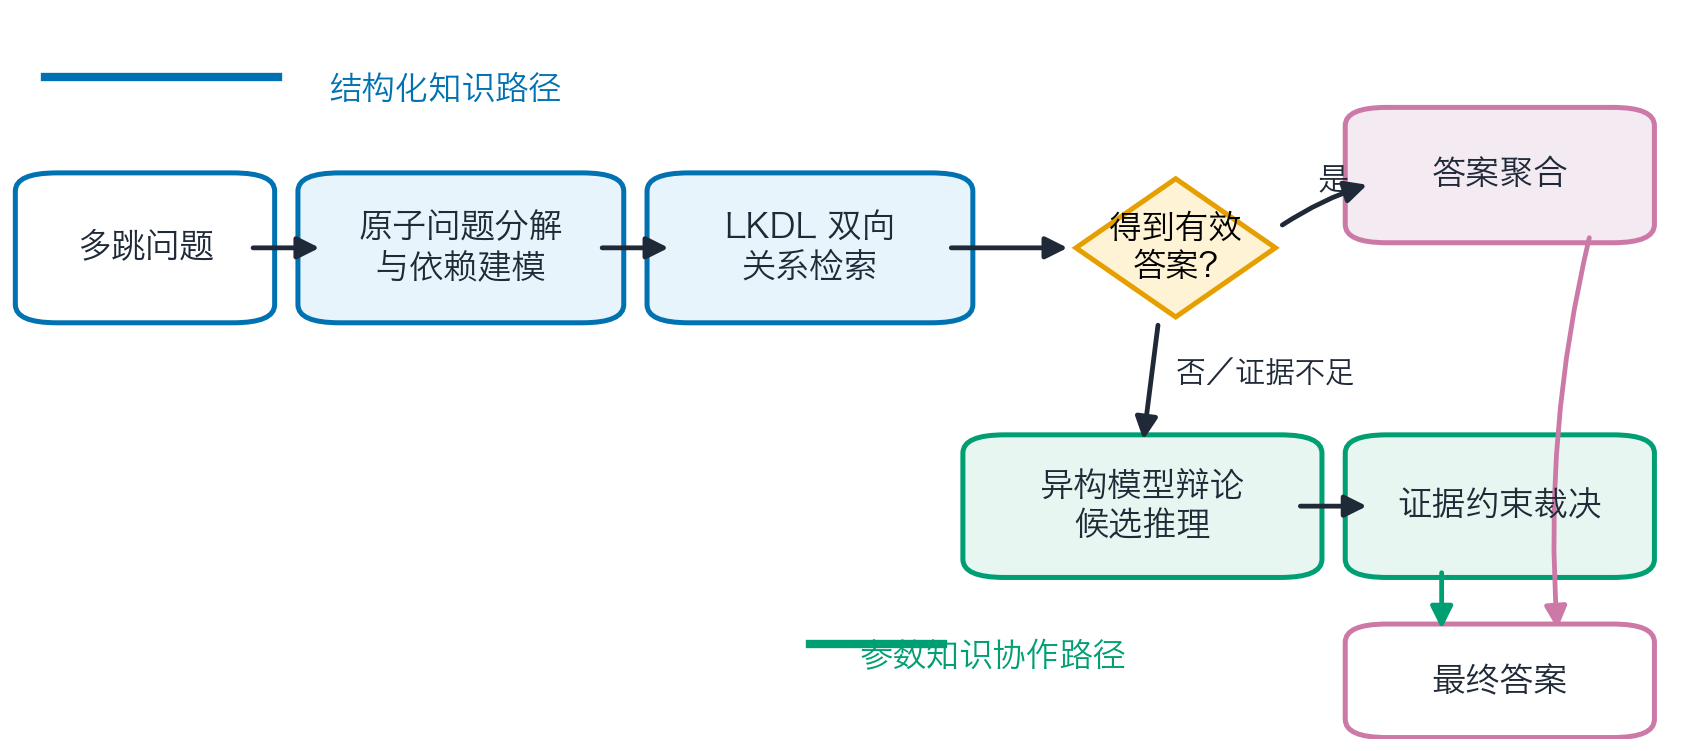
分工很清楚:STEP 1–3 负责「把该查的查全」,STEP 4 负责「诚实地判断够不够」,STEP 5 负责「不够时带着对抗性地补」。GLKMD 的独特性只在 STEP 4→5 这个切换条件上,而不是在任何单个环节本身。
- 只围绕一个主题实体
- 表达一项不可继续拆分的关系约束
- 答案能作为后续子问题的中间变量,或作为最终输出
这三条保证了每一步检索都是「可验证的最小单元」——不必一次猜完整条路径。
S0 = ⟨ Q, ℰ, ∅ ⟩ ℰ = {e₁, e₂, …, en} 为候选实体
e* = argmax frel(ei, Q) q₁ = Decompose(Q, e*)
第三项 ∅ 表示:当前还没有中间推理上下文
当已有上下文 C ≠ ∅ 时:
分支 A —— 语义连续(gcont(ei, C) = true)
qk+1 = Decompose(Q, ei | C) 沿着当前实体继续往下问
分支 B —— 需要切换主题
ej = argmax frel(e, C),qk+1 = Decompose(Q, ej | C)
终止条件 ψ(C) = true 时输出 Output,否则继续 Search(qi)。
「前一步检索结果更新 C 后再决定下一步实体」——DARA(ACL 2024)的「迭代式分解」已经这么做了(第 20 页)。GLKMD 的差异只在于分支 A/B 的显式切换条件 gcont。这一条我写在论文 2.2 节,不当作独立贡献。
标准三元组查询区分头实体和尾实体。如果现实语义里关系近似对称,但图谱只存了一个方向,那么只以指定实体为头结点去查,就会漏掉反向连接。
在多跳场景下这更致命:一次遗漏会阻断后面整条路径。
类比:你要找「谁和张三同姓」,但图谱里只存了「张三 → 姓 → 张」。正向查不到「张 → 还有谁」,反向一查就有了。
LKDL 统一表达实体元、关系元和知识元,为关系提供两个方向:
「实体具有某关系」
「某关系包含实体」
张三 # 姓氏 → 属性方向
姓氏 * 张 → 取值方向
对原子问题 qi,生成 LKDL 查询,同时考虑实体处于三元组头部和尾部两种情况,合并为候选集 Ti。
论文里写得很明确:「当前实验没有单独比较 LKDL 与 SPARQL 的查询成功率、延迟或表达长度,因此本文不据此宣称 LKDL 在一般场景中必然更快或更完整。」而且 DoM 的 KG Agent 已经用 SPARQL 顺带取了正向 + 逆向关系——「双向」本身不是我的发明,我的差异只在表示层。这是四个差异点里最弱的一个。
问题 Q 与候选三元组 T = ⟨h, r, t⟩ 的相关性拆成三块:A 实体直接对齐、R 关系匹配、C 上下文连接。
S(Q,T) = 0.45·A + 0.35·R + 0.20·C
| 分项 | 取值规则 |
|---|---|
| A | 核心实体完全匹配 0.4 · 覆盖过半实体 0.3 · 仅匹配一个 0.1 · 不匹配 0 |
| R | 关系显式匹配 0.3 · 隐式匹配 0.2 · 不匹配 0 |
| C | 连接多个问题实体 0.1 · 连接一个 0.05 · 无连接 0 |
阈值 θ = 0.6:保留 S ≥ θ 的三元组作为结构化证据;若集合为空,按相关性取 Top-N 作为回退证据,交给 STEP 5。
按原稿这套数值算,S 的理论最大值只有:
0.45×0.4 + 0.35×0.3 + 0.20×0.1
= 0.305 < θ = 0.6
也就是说:永远不可能有任何一个三元组达标,门控会 100% 走回退分支。
更麻烦的是:现有实验代码里的 relevance_score 实际表现为语言模型筛选,不是这个固定公式。
所以表 1 的数字验证的是「整个系统的端到端表现」,不能把增益单独归因于这个评分公式。
框架意图是清楚的(证据够就继续结构化推理,不够才交给模型),但实现细节必须统一:子分数尺度、加权方式、阈值 θ 和 Top-N 取值,都要以产生最终结果的那份代码为准。已列为投稿前第 1 优先事项。
A0 = MA(Q, Ge) ← 初始观点
B0 = MB(Q, Ge, A0) ← 反方观点
Ak+1 = MA(Q, Ge, Bk),Bk+1 = MB(Q, Ge, Ak+1)
C* = MC( {Ai, Bi}ki=0, Ge ) ← 裁决
裁决原则:MC 应优先检查候选观点是否与检索到的实体和关系一致,而不是仅凭文本流畅度选答案——这是防止辩论退化成「谁说得漂亮听谁的」。
- 没有做过「有 / 无辩论」的消融。表 2 比较的是骨干模型与知识条件,不是辩论的开关。
- 没有同预算对照。缺了「多数投票 / 自一致性 / 同构代理」这三个关键对照组。
- 最大轮数 K、停止阈值、实际是一轮还是多轮,都还没和代码统一。
所以论文里我只把辩论写成「框架的组成部分」,不声称它单独贡献了表 1 里的全部增益。
以及数据没说什么
然后用一页专门讲完整图谱上的负结果和我发现的三个问题。
随着三元组缺失率上升,GLKMD 能否减缓 Hits@1 的性能退化?
相对同一设置下最强基线的优势,如何随数据集和缺失率变化?
在不同骨干模型和知识条件下,结果模式是否保持一致?
Complex WebQuestions(CWQ)——含组合约束、多跳链更长。
WebQuestionsSP(WebQSP)——以相对较短的知识库查询为主。
各随机抽取 1000 个问题。为控制缺失强度,随机删除每个问题相关图谱中 20% / 40% / 60% / 80% 的三元组,得到 IKG-20% 至 IKG-80%;不删除记为 CKG(完整图谱)。另外报告不提供图谱证据的 NKG 设置。
基线:ToG(LLM 引导的图搜索)与 GoG(面向不完整 KG、搜索中允许生成缺失事实)。
指标:Hits@1,即排名第一的预测答案与标准答案匹配的样本比例。
骨干:主实验统一用 GPT-3.5,以减少骨干差异对方法比较的干扰;另报告 Qwen-2 与 Llama-3 两个标签。
解码设置:最大生成长度 256、温度 0.7。
① 现有材料未给出随机种子、是否每个问题独立采样、重复构图次数和结果方差,所以本文不报告置信区间和显著性;② 只报告绝对百分点差异,不使用「统计显著」这类措辞;③ 原稿记录的各版本模型参数规模存在冲突,因此结果表沿用最终表格的标签,不推断未确认的版本。
| 数据集 | 方法 | CKG | IKG-20% | IKG-40% | IKG-60% | IKG-80% |
|---|---|---|---|---|---|---|
| CWQ | ToG | 47.2 | 40.5 | 37.9 | 33.7 | 31.4 |
| GoG | 55.7 | 44.9 | 44.3 | 36.2 | 34.4 | |
| GLKMD | 55.7 | 54.7 | 53.1 | 50.9 | 48.3 | |
| WebQSP | ToG | 76.9 | 70.3 | 61.4 | 60.6 | 55.9 |
| GoG | 78.7 | 70.8 | 66.6 | 62.6 | 56.5 | |
| GLKMD | 73.5 | 72.2 | 71.1 | 67.7 | 65.2 |
粗体 = 同一数据集与知识条件下的最高值。CWQ 的 CKG 一列,GLKMD 与 GoG 并列 55.7;WebQSP 的 CKG 一列,GLKMD(73.5)低于 GoG(78.7)——这两格就是「完整图谱上不占优」的直接证据。
① 看每一行从 CKG 到 IKG-80% 掉了多少:
| CWQ | 降幅 |
|---|---|
| ToG | −15.8 |
| GoG | −21.3 |
| GLKMD | −7.4 |
| WebQSP | 降幅 |
|---|---|
| ToG | −21.0 |
| GoG | −22.2 |
| GLKMD | −8.3 |
GLKMD 的曲线明显更平缓。
CWQ 从 IKG-20% 起、WebQSP 从 IKG-20% 起(+1.4)。缺失越严重,领先越多——WebQSP 的增益从 +1.4 一路涨到 +8.7(见第 41 页)。
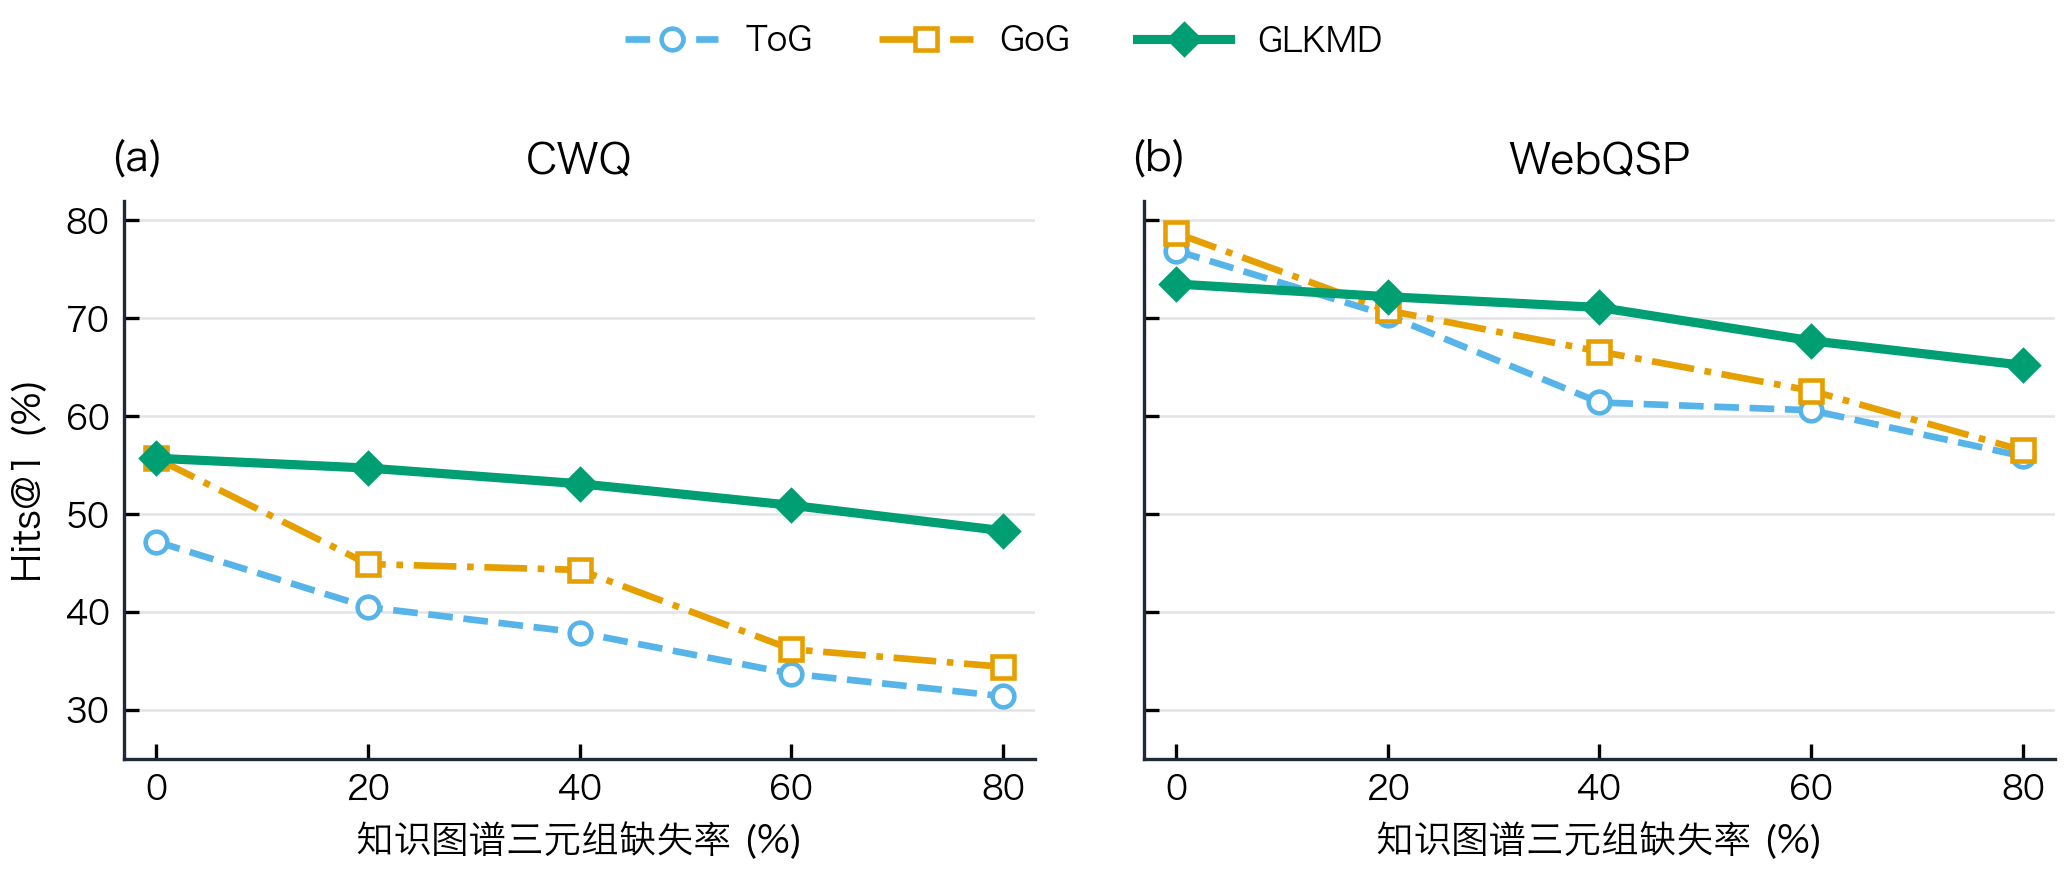
三种方法都随缺失率上升而下降,但 GLKMD 的曲线更平缓。0% 表示 CKG,20%–80% 表示随机删除对应比例的三元组。
它只说明在随机删边这一种缺失模式下退化更慢。随机删除不等价于现实缺失——它可能删掉大量与答案无关的边,也可能偶然删掉唯一关键路径(见第 43 页)。
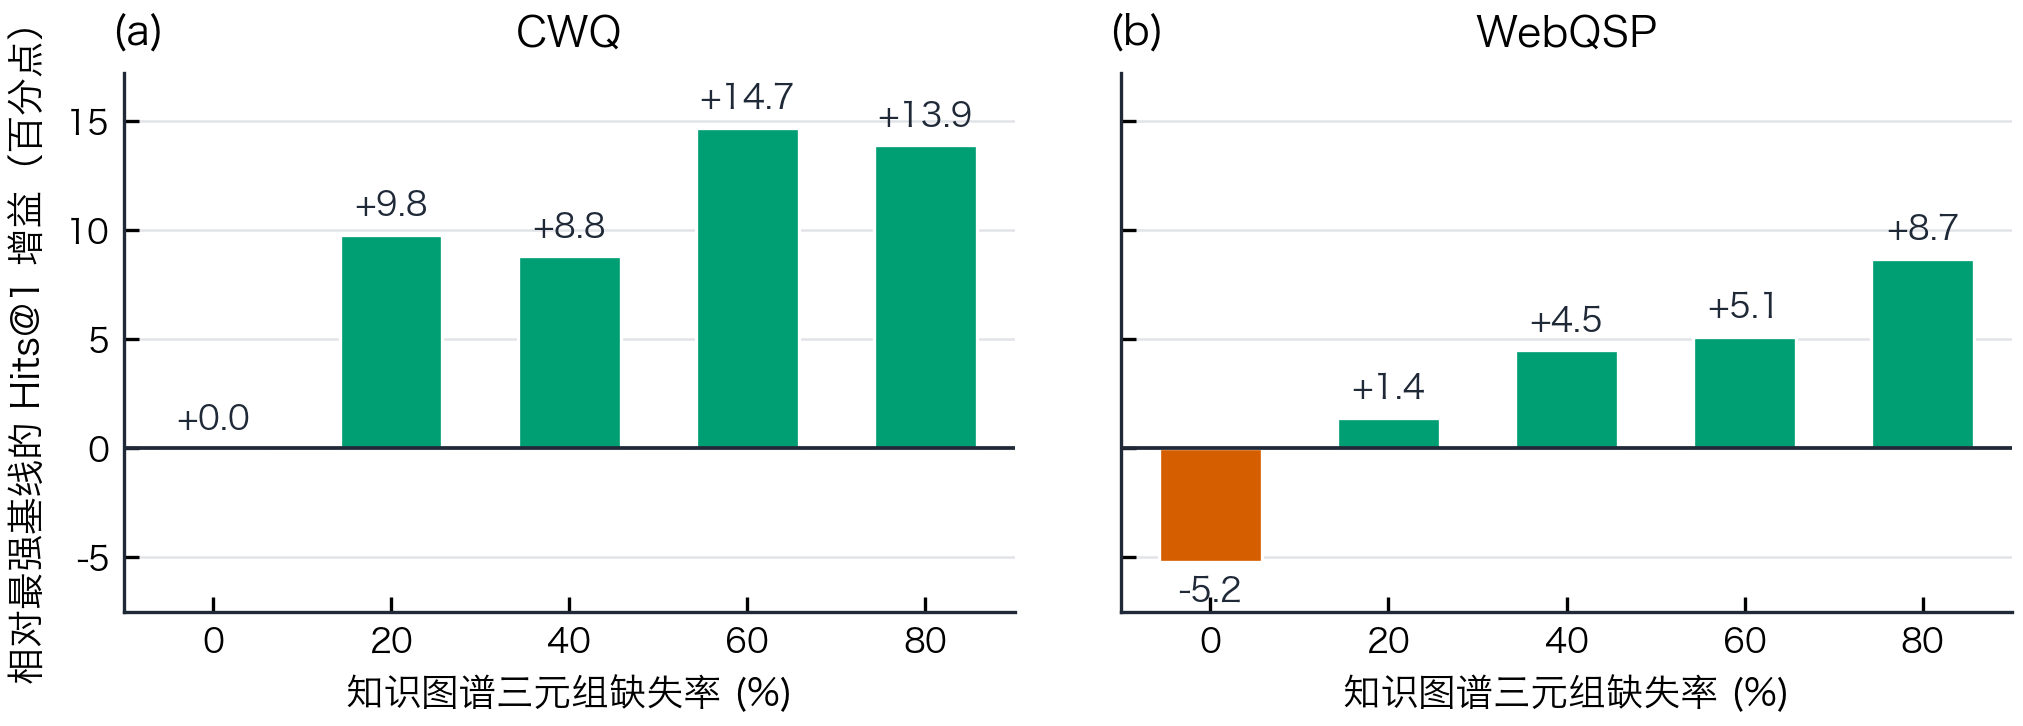
CWQ:IKG-20% +9.8 → 40% +8.8 → 60% +14.7 → 80% +13.9
WebQSP:IKG-20% +1.4 → 40% +4.5 → 60% +5.1 → 80% +8.7
CWQ 上与 GoG 持平(0);WebQSP 上比 GoG 低 5.2 个百分点。所以数据支持的是「知识缺失时退化更慢」,不是「在所有场景准确率更高」。
| 数据集 | 骨干 | CKG | IKG-40% | NKG |
|---|---|---|---|---|
| CWQ | GPT-3.5 | 55.7 | 53.1 | 50.9 |
| Qwen-2 | 57.3 | 49.5 | 45.2 | |
| Llama-3 | 53.6 | 48.9 | 44.3 | |
| WebQSP | GPT-3.5 | 73.5 | 71.1 | 67.7 |
| Qwen-2 | 75.8 | 74.3 | 73.5 | |
| Llama-3 | 77.9 | 75.6 | 71.6 |
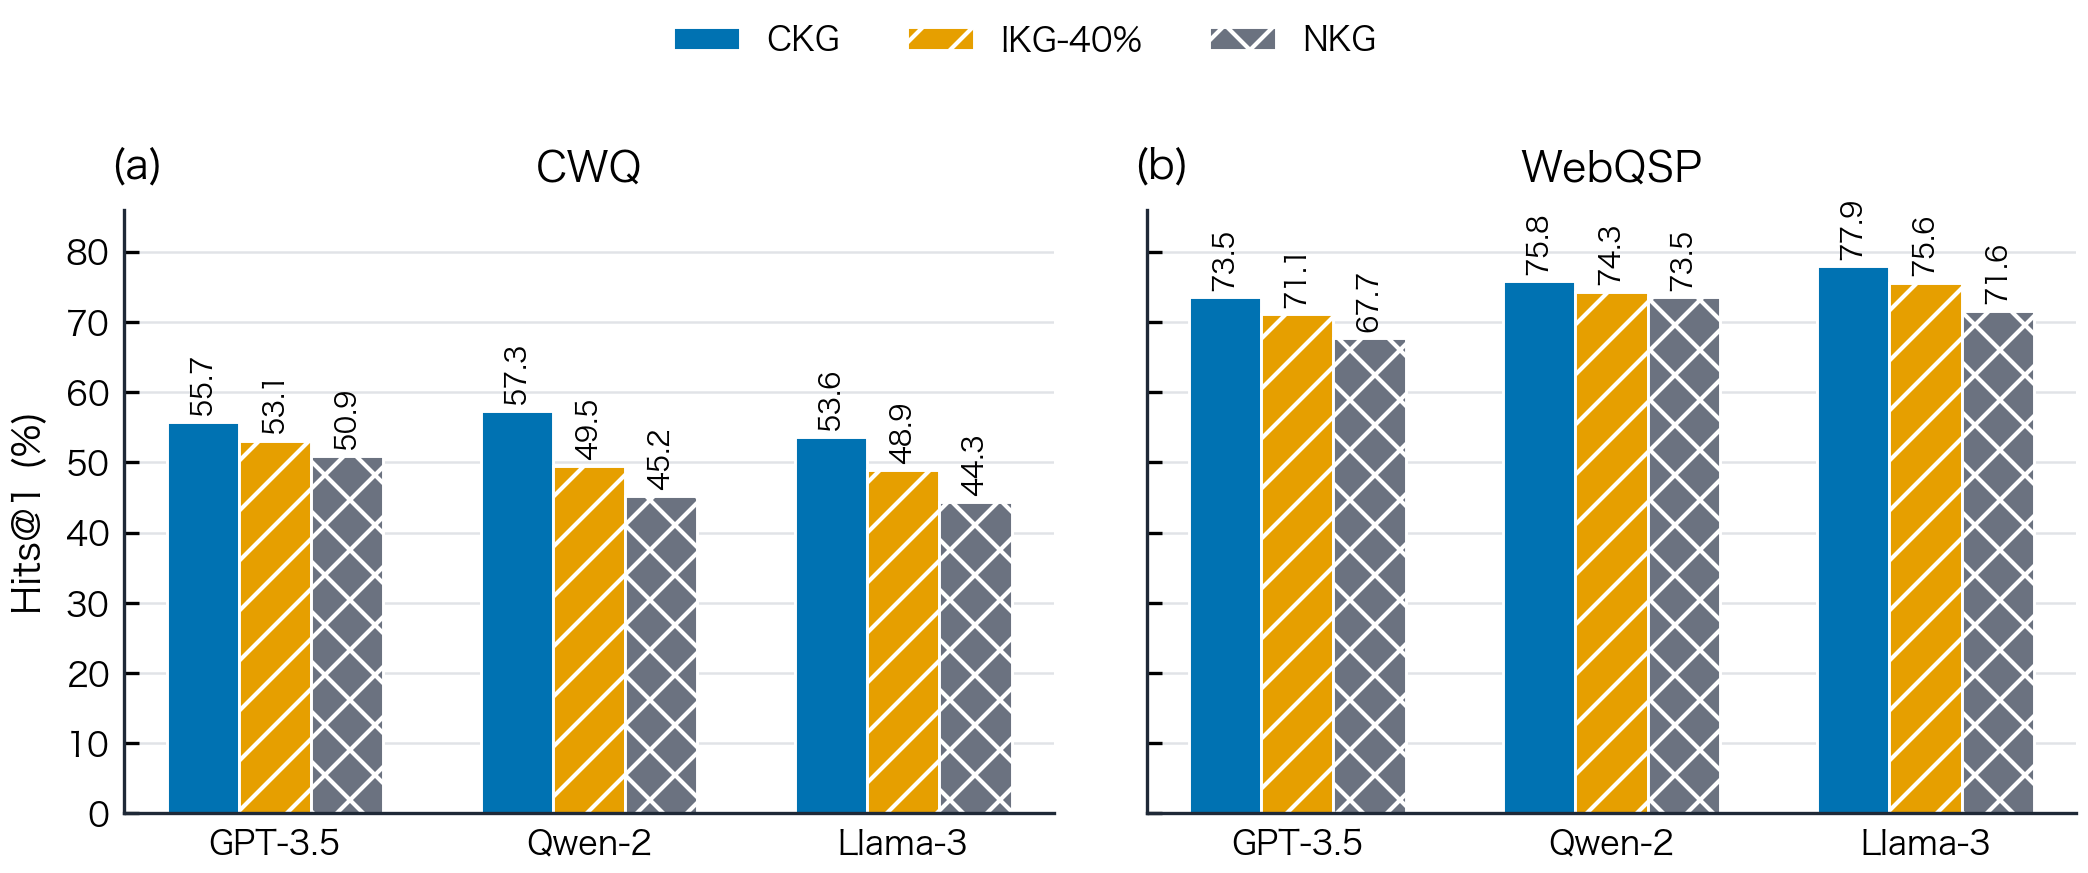
表 2 同时改变了知识条件和骨干模型,却没有给出「关闭辩论 / 同构代理 / 多数投票 / 单模型多采样」的对照。更稳妥的结论是:GLKMD 管线能在所报告的三个模型标签上得到可比较的结果,而各模块对性能的独立贡献仍待验证。另外,CWQ 三个骨干从 CKG 到 NKG 分别下降 4.8 / 12.1 / 9.3,WebQSP 下降 5.8 / 2.3 / 6.3——由于没有参数记忆探测,这个差异不能直接解释为某模型组合推理更强。
只用按比例随机删除三元组,没覆盖关系类型偏置、实体长尾、跨源冲突、时间变化。随机删除可能删掉大量与答案无关的边,不同问题的有效难度未必随名义缺失率线性变化。所以结果只支持「随机缺失压力测试下的结论」。
没有多随机种子重复、标准差、置信区间或显著性检验。因此只报告绝对百分点差异,不使用「统计显著」措辞。
缺少问题分解、LKDL、三元组筛选、辩论的逐项消融,也没有同预算的多数投票 / 自一致性 / 单模型多采样对照。表 1 的增益不能被分解到任何单一模块。
原稿评分尺度与阈值存在数学冲突(最大值 0.305 达不到 θ=0.6),而现有代码用模型筛选三元组。骨干版本、Top-N、辩论轮数、停止条件也未完全统一。投稿前必须以产生最终结果的实际代码为准。
模型在 NKG 或 IKG 下答对,可能来自参数记忆而非补全推理。Hits@1 无法区分「答案正确但证据错误」「答案直接记忆」「真正的多跳组合推理」。BRINK(第 08 页)指出的正是这一层。
① 摘要里明确限定「随机缺失压力测试」;② 同时报告完整图谱上的持平与负结果;③ 主动引用 BRINK、DoM 并承认交叉;④ 投稿前必做清单的第一条就是统一评分与辩论模块的真实实现。
是怎么做出来的
串成了一条可复现的链路。这一节讲它长什么样,以及它在 GLKMD 上实际产出了什么。
检索 → 下载 → 文件类型与页数校验 → 按主题归档 → 生成 BibTeX → 逐条核验定位。
产出:7 个主题目录 + .bib + 核验记录
假设 → 改动 → 测量 → 学习 → 保留或回滚 → 重复。控制脚本负责测量、提交、回滚和事件历史,我负责提假设。
配套:scientific-toolkit 做统计、数据处理与出版级图表
research-writing-skill 负责中文正文的起草与修改;awesome-ai-research-writing 再做一轮逻辑、语言、去 AI 味和严格审稿。
产出:GLKMD_revised_zh.md + revision_audit.md
/ars-plan(计划)· /ars-outline(提纲)· /ars-lit-review(文献综述)· /ars-citation-check(引用核验)· /ars-reviewer(模拟审稿)· /ars-full(全流程)。提假设 → 改代码 → 测量 → 学习 → 保留或回滚 → 重复。不做一次性修改。第 27 页那张「DoM 比我高 8.9 个点」的对比表、第 35 页那个「评分公式最大值只有 0.305」的发现,都不是工具自动产出的,是我逐篇读论文、逐行核对稿件找出来的。流水线解决的是规模和一致性,不解决「这个结论到底站不站得住」。
figures/scripts/plot_results.py,读取 figures/data/experiment_results.csv 生成,并且带单元测试(figures/tests/)。数据改了,图能一键重出——而不是在 PPT 里手改数字。revision_audit.md。第 27 页承认 DoM 覆盖了我的故事、第 35 页的评分公式冲突、第 43 页的五条局限——都是这一环逼出来的。原稿里「首次」「独立提出」这类表述也是在这里被删掉的。| 环节 | 技能 | 实际产物(都在项目目录里) | 对应本次汇报 |
|---|---|---|---|
| 文献检索 与核验 | ARS + scientific-toolkit | literature/ 下 7 个主题目录、26 份 PDF 00_index/GLKMD_references.bib phase2_investigation/literature_search_and_verification.md | 第 03–29 页的 16 篇深讲 + 第 50–51 页总览 |
| Gap 分析与 背景底稿 | academic-research-suite | phase3_analysis/background_and_related_work_draft_zh.md | 每一幕末尾的 「留下了什么问题」 |
| 实验执行 与回滚 | codex-autoresearch | 可回滚的实验迭代与事件历史(提假设 → 改 → 测 → 保留/回滚) | 第 38–42 页的数据来源 |
| 统计与图表 | scientific-toolkit-skill | figures/data/experiment_results.csv · figures/scripts/plot_results.py figures/output/ 下 4 组 SVG/PDF/PNG · figures/tests/test_plot_results.py | 第 32、40、41、42 页 的四张图 |
| 论文正文 | research-writing-skill | manuscript/GLKMD_revised_zh.md | 第 31–36 页的方法 与第 39 页的表格 |
| 严格审稿 | awesome-ai-research-writing | manuscript/revision_audit.md | 第 27、35、43 页 ——最扎实的三页 |
| 出图与交付 | academic-figure-generator + office-academic-skill | 框架流程图 + 这份 HTML PPT | 第 32 页与全场 |
一致性。26 篇文献的会议、年份、数字不会前后矛盾;数据改了图能一键重出;引用条目经过 DOI 核验而非手抄。这些正是人工处理 26 篇时最容易出错的地方。
「这个故事到底成不成立」。DoM 比我强、评分公式自相矛盾、缺模块消融——这些都是我自己读出来、核对出来的。流水线放大判断力,不替代判断力。
| 论文(中文译名 / 原标题) | 会议 | 主题 | 在这条主线里的作用 |
|---|---|---|---|
| KG-GPT A General Framework for Reasoning on Knowledge Graphs Using LLMs | Findings of EMNLP 2023 | LLM+KG | 把推理分成句子分割、图检索、推理多阶段,是「分阶段调用图」这一路线的早期代表。与第 11–13 页的图上推理同源。 |
| StructGPT A General Framework for LLM to Reason over Structured Data | EMNLP 2023 | LLM+KG | 用「调用—读取—推理」组织结构化数据访问,是接口层的奠基工作。GLKMD 的 LKDL 查询生成属于同一层。 |
| ChatKBQA A Generate-then-Retrieve Framework for KBQA | Findings of ACL 2024 | 语义解析 | 先生成逻辑形式、再检索实体关系的范式。BRINK 指出它在缺失知识下从 76.5 掉到 39.3——是「语义解析路线扛不住缺失」的证据。 |
| FRAG A Flexible Modular Framework for RAG based on KGs | Findings of ACL 2025 | 子图检索 | 把 KG-RAG 拆成可替换的检索与生成模块,提供系统级比较框架。与第 22 页 SubgraphRAG 同属检索端工程化路线。 |
| Chain-of-Question A Progressive Question Decomposition Approach for Complex KBQA | Findings of ACL 2024 | 问题分解 | 渐进式生成并回答子问题。与 DARA、KELDaR 共同构成分解路线的三篇代表作(第 20–21 页)。 |
上半部分的共同点:它们都在「图谱可用」的前提下,优化「怎么问」和「怎么取」——也就是第一幕说的第二层(推理层)问题。没有一篇处理第一层(事实缺失)或第三层(评测混淆)。
| 论文(中文译名 / 原标题) | 会议 | 主题 | 在这条主线里的作用 |
|---|---|---|---|
| Divergent Thinking via MAD Encouraging Divergent Thinking in LLMs through Multi-Agent Debate | EMNLP 2024 | 辩论 | 「观点多样性」的原始出处。是 GLKMD 采用异构模型(而非同模型换角色)的理论依据之一,与第 28 页呼应。 |
| Sparse Communication Topology Improving Multi-Agent Debate with Sparse Communication Topology | Findings of EMNLP 2024 | 辩论 | 辩论拓扑与成本控制,提示「不是通信越密越好」。对应第 28 页「辩论不是免费的」。 |
| RAIN-TF Fusing Essential Text for QA over Incomplete Knowledge Base | Electronics 2025 | 不完整 KG | 关键文本筛选与关系感知图融合。是第 06–07 页「用外部文本补缺失」这条线在 2025 年的延续。 |
| LLM-assisted KG Engineering Experiments with ChatGPT | Springer 2024 | 综述/工程 | LLM 辅助知识图谱构建的工程实践——说明图谱本身是怎么被造出来的,也就解释了长尾实体为什么会漏(呼应第 05 页)。 |
| LLMs Meet KGs for QA Synthesis and Opportunities | EMNLP 2025 | 综述 | LLM + KGQA 的分类与综述,是 GLKMD 相关工作一节的分类依据(知识表示 / 检索 / 推理 / 答案生成)。 |
下半部分对应三条支线:辩论的方法论(前两篇)、不完整知识问答的另一条延续(RAIN-TF)、图谱本身的工程与综述(后两篇)。加上前面深讲的 16 篇,文献库 26 篇就覆盖完了。
- 问题是真的。低完整度图谱上,ToG 和 GoG 的性能下降 15–22 个百分点,而 GLKMD 只下降 7–8 个点。曲线平滑这件事本身是稳定的。
- 贡献是受限的。GLKMD 的价值集中在不完整知识条件:完整图谱上它在 CWQ 与 GoG 持平、在 WebQSP 还低 5.2 个点。我不用「全面领先」来包装它。
- 论证是不完整的。缺模块消融、缺同预算对照、缺统计重复、评分公式还有数学冲突。投稿前的第一件事是把这些补上,而不是继续加模块。
- 统一实现——评分公式、阈值、辩论轮数,以产生最终结果的代码为准
- 同基座同设置重跑 DoM——这是最尖锐的对标(第 27 页)
- 补消融——分解 / LKDL / 评分 / 辩论逐项关掉,并加多数投票、自一致性、同构代理对照
- 换缺失模式——关系偏置、长尾实体、时间更新,而不只是随机删边
- 补忠实度指标——证据召回、路径忠实度、参数记忆探测(回应 BRINK)
这一轮读文献最大的收获,不是找到了 GLKMD 的卖点,而是找到了它的边界。
DoM 在 AAAI 2026 已经覆盖了叙事的大部分,这件事早知道比晚知道好——它把接下来的工作从「再想一个创新点」变成了「把已有的声明坐实」。
组合层面确实没有创新。差异只在四点(触发时机、模型异构、LKDL 表示、以图为主),其中只有前两点可能构成机制差异,但都还没有消融证据。现阶段我声称的是受限的实证结果,不是方法新颖性。
这是预期行为,不是失败。完整图谱上,额外的分解、筛选和模型协作会引入错误传播和不必要的生成;GoG 和 ToG 的直接图探索更高效。KAR(ACL 2019)在 2019 年就报告过同样的现象(16.8% 的样本加文本反而更差)。
目前不知道。没有做「有 / 无辩论」消融,也没有多数投票、自一致性、同构代理的同预算对照。而且 Demystifying MAD 证明朴素辩论可能不如多数投票。所以我把辩论定位成框架组件,不声称它贡献了全部增益。
不能。随机删除可能删掉大量与答案无关的边,也可能偶然删掉唯一关键路径,有效难度不随名义缺失率线性变化。所以我把结论限定为「随机缺失压力测试下的鲁棒性」,并计划加入关系偏置、长尾实体、时间更新等更现实的缺失模式。
很可能有一部分是。BRINK 发现给实体加文本标签后成绩显著上升、而官方 ID 与随机 ID 表现几乎一样——说明模型很大程度上靠内部记忆而非符号推理。Hits@1 区分不了这三种情况,我需要补参数记忆探测和证据忠实度指标。
流水线只保证一致性(会议、年份、数字不矛盾,图表可从数据一键重出,引用经 DOI 核验),不保证结论正确——DoM 的威胁、评分公式的冲突、消融的缺失,都是人工读出来核对出来的。而且 research-writing 这条技能明确禁止编造数据、DOI 和实验结果。
谢谢,请批评
① GLKMD 剩下的那点差异,值不值得做下去?
② 如果要投稿,应该先补消融,还是先换更真实的缺失模式?